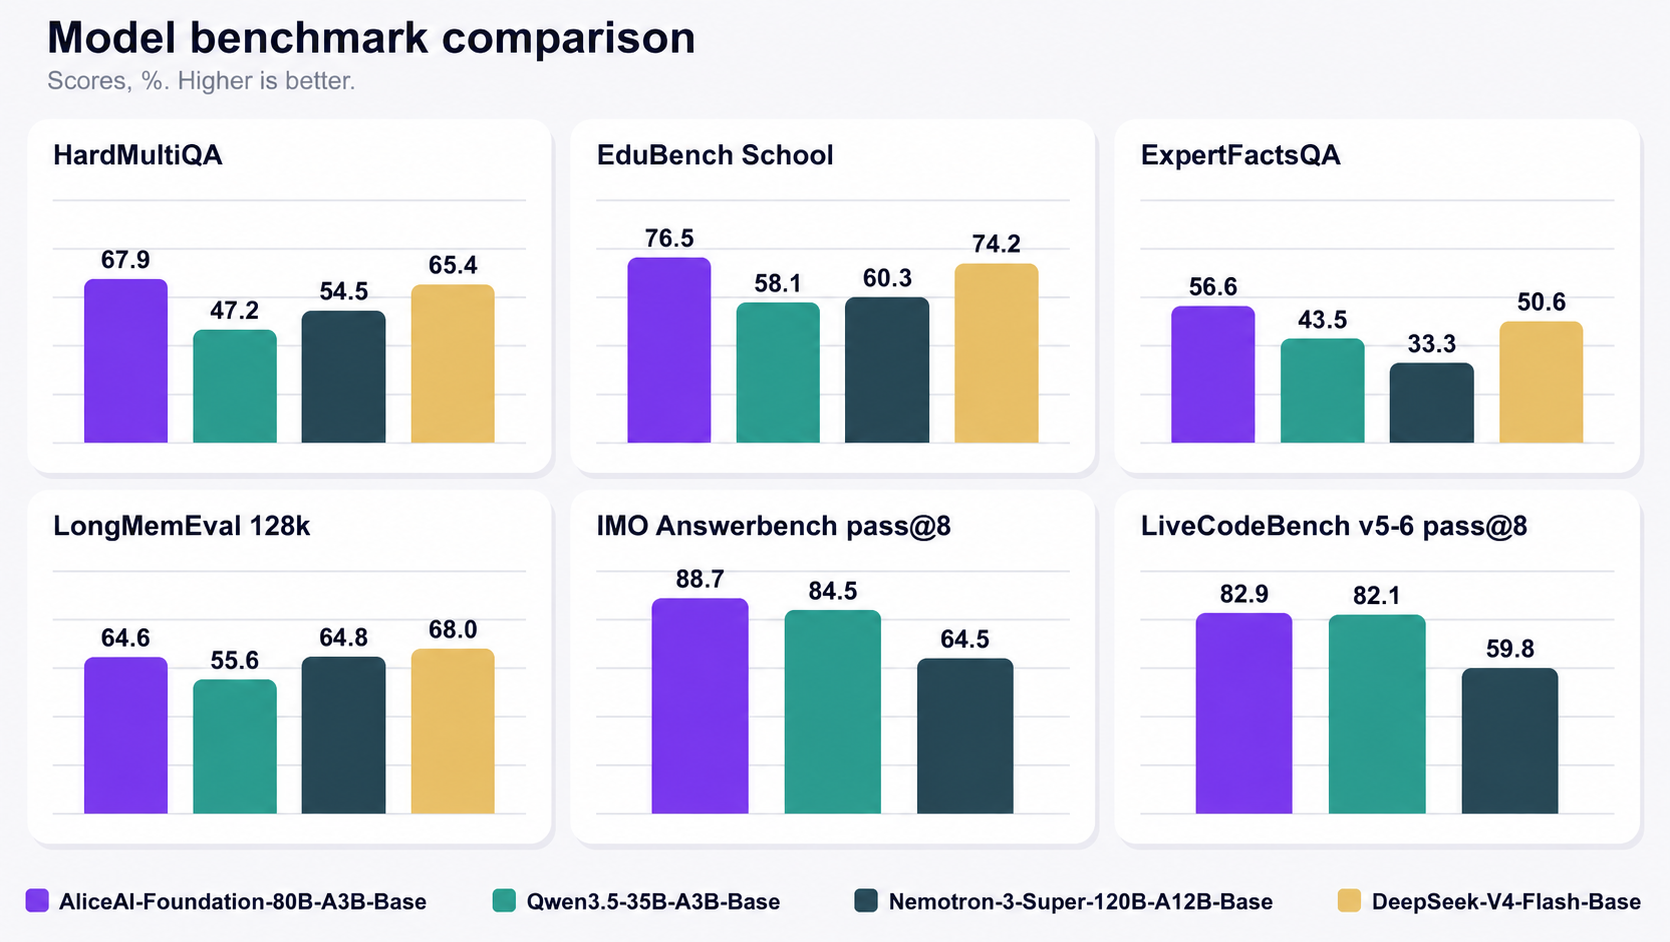
--- license: apache-2.0 language: - ru - en library_name: transformers pipeline_tag: text-generation tags: - custom_code - mixture-of-experts - vllm --- # AliceAI-Foundation-80B-A3B-Base [English version](./README_en.md) AliceAI-Foundation-80B-A3B-Base – базовая языковая модель с гибридной архитектурой и MoE-слоями. Модель содержит 80 млрд параметров, из которых для каждого токена активируются 3 млрд, и поддерживает контекст длиной до 262 144 токенов. Модель была обучена полностью с нуля. При создании модели мы заново собрали обучающий корпус, выбрали архитектуру и гиперпараметры, а также подготовили данные для сложных рассуждений и взаимодействия с инструментами. Ключевые решения проверялись в серии отдельных обучений с нуля объёмом по 2 трлн токенов каждое. В математике, программировании и других задачах на рассуждения модель показывает результаты на уровне более крупных опенсорс-моделей, а особенно сильна в задачах на фактические знания на русском языке. Вместе с весами мы публикуем фактологические бенчмарки [WikiWebFacts](https://huggingface.co/datasets/yandex/WikiWebFacts) и [HardMultiQA](https://huggingface.co/datasets/yandex/HardMultiQA), ориентированные на русскоязычный контекст, и протоколы их оценки. Подробно про эту модель можно прочитать в [статье на Хабре](https://habr.com/ru/companies/yandex/articles/1083300/). Сравнение по бенчмаркам ## Обзор модели - Тип: авторегрессионная языковая модель - Этап обучения: предобучение - Языковая модель - Количество параметров: 80B всего, 3B активных - Размер скрытого состояния: 2048 - Размер словаря: 129024 - Количество слоев: 48 - Схема слоёв: 12 × (3 × (KDA → MoE) → 1 × (Gated Attention → MoE)) - KDA: - Количество query-голов: 32 - Количество KV-голов: 32 - Размерность query-головы: 128 - Размерность KV-головы: 128 - Рамер ядра свертки: 4 - Gated Attention: - Количество query-голов: 16 - Количество KV-голов: 2 - Размерность query-головы: 256 - MoE: - Количество экспертов: 512 - Top-K: 10 + 1 общий эксперт - Промежуточная размерность эксперта: 512 - MTP: 1 слой - Длина контекста: 262144 ## Бенчмарки

Названия русскоязычных бенчмарков выделены зелёным, англоязычных — синим.

Все замеры в этом разделе проведены во внутренней инфраструктуре замеров, инференс в фреймворке vllm с t=0 для всех моделей. Жирным выделен победитель в каждой строчке.

Бенчмарк AliceAI-Foundation-80B-A3B-Base Qwen3.5-35B-A3B-Base GLM-4.5-Air-Base (106B-A12B) Nemotron-3-Super-120B-A12B-Base DeepSeek-V4-Flash-Base (284B-A13B)
Факты
WikiWebFacts
5-shot, бенчмарк на знание фактов на русском языке.
86.562.470.272.883.2
HardMultiQA
5-shot, бенчмарк на знание фактов на русском языке.
67.947.248.654.565.4
CultCat
4-shot, бенчмарк на знание культурных фактов. Подробнее — в статье на Хабре.
86.559.259.166.380.7
TriviaQA
5-shot, открытый бенчмарк на знание фактов на английском языке; вместо метрики Exact Match используется LLM-as-a-judge.
79.071.483.589.889.4
Образовательные бенчмарки
EduBench Russian
5-shot, бенчмарк образования, собранный на основе запросов к Алисе.
74.242.939.044.067.7
EduBench Literature
5-shot, бенчмарк образования, собранный на основе запросов к Алисе.
73.851.851.455.869.1
EduBench History
5-shot, бенчмарк образования, собранный на основе запросов к Алисе.
82.065.962.870.276.9
EduBench English
5-shot, бенчмарк образования, собранный на основе запросов к Алисе.
76.171.767.271.382.9
Экспертные знания
ExpertFactsQA Medicine
5-shot, бенчмарк на фактические знания, составленный профильными экспертами.
63.659.050.642.360.7
ExpertFactsQA Law
Сложный 5-shot, бенчмарк на фактические знания, составленный профильными экспертами.
49.627.922.524.340.5
Экзамены
EGE CoT
5-shot, бенчмарк из заданий части А ЕГЭ по различным предметам.
90.584.777.884.390.3
MMLU-Pro CoT
5-shot, открытый бенчмарк на знания и рассуждения по широкому набору предметов на английском языке.
66.863.258.469.966.5
SuperGPQA CoT
5-shot, открытый бенчмарк с вопросами, составленными экспертами из разных научных областей.
44.343.635.446.646.1
Математика
MATH-500
5-shot, бенчмарк с математическими задачами; используется LLM-as-a-judge и более длинные рассуждения в few-shot-примерах.
91.181.960.284.880.7
EduBench Math
5-shot, бенчмарк образования, собранный на основе запросов к Алисе
79.380.056.969.776.3
EduBench Math University
5-shot, бенчмарк образования, собранный на основе запросов к Алисе.
70.169.951.467.468.6
Код
BigCodeBench 1-shot pass@1
1-shot, наша реализация BigCodeBench с улучшенными тестами.
48.343.544.548.849.1
LiveCodeBench v5-6 CoT 1-shot pass@1
1-shot, открытый бенчмарк со сложными задачами по программированию, в которых требуется найти алгоритм и реализовать его в коде.
50.550.422.650.438.1
Длинный контекст
FinQA 128k
5-shot, длинная модификация опенсорсного FinQA, задачи на аналитику по финансовым отчётам.
74.173.535.571.774.1
LongMemEval 128k
5-shot, открытый бенчмарк с задачами на поиск и использование информации из длинной истории диалога.
64.655.650.664.868.0

Все замеры в этом разделе проведены во внутренней инфраструктуре замеров, инференс в фреймворке vllm с t=1 и штрафами за повторы (repetition_penalty=1, presence_penalty=1.5) для всех моделей. Жирным выделен победитель в каждой строчке.

Бенчмарк AliceAI-Foundation-80B-A3B-Base Qwen3.5-35B-A3B-Base Nemotron-3-Super-120B-A12B-Base
Сложные рассуждения
AIME 2026 pass@32
0-shot, задачи American Invitational Mathematics Examination.
96.796.790.0
HMMT 2026 Feb pass@32
0-shot, задачи февральского математического турнира Harvard–MIT.
96.987.966.7
IMO Answerbench pass@8
0-shot, задачи Международной математической олимпиады.
88.784.564.5
CodeForces CPP pass@8
0-shot, соревновательные задачи Codeforces на C++.
68.973.756.6
LiveCodeBench v5-6 pass@1
0-shot, открытый бенчмарк с задачами на поиск и использование информации из длинной истории диалога.
60.451.934.7
LiveCodeBench v5-6 pass@8
0-shot, открытый бенчмарк с задачами на поиск и использование информации из длинной истории диалога.
82.982.159.8
## Как использовать ### Transformers Модель можно запустить через Transformers. Референсная версия Transformers — 5.16.1. Для выполнения KDA-слоёв на GPU требуется `flash-linear-attention` с поддержкой KDA: ```bash python3 -m venv .venv source .venv/bin/activate pip install \ transformers[sentencepiece]==5.16.1 \ accelerate==1.14.0 \ flash-linear-attention==0.5.0 ``` ```python import torch from transformers import AutoModelForCausalLM, AutoTokenizer model_id = "yandex/AliceAI-Foundation-80B-A3B-Base" tokenizer = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True) model = AutoModelForCausalLM.from_pretrained( model_id, trust_remote_code=True, dtype=torch.bfloat16, device_map="auto", ) prompt = "Есть 256 монет с разным весом, за какое минимальное количество попарных взвешиваний можно найти вторую по весу монету?" inputs = tokenizer(prompt, return_tensors="pt").to(model.device) output_ids = model.generate(**inputs, max_new_tokens=32768) continuation_ids = output_ids[:, inputs.input_ids.shape[1] :] print(tokenizer.decode(continuation_ids[0], skip_special_tokens=True)) ``` ### vLLM Также модель можно запустить через vLLM. Для запуска требуются Docker и NVIDIA Container Toolkit. ```bash docker run --name alice-vllm --pull=always --gpus '"device=0,1,2,3"' --ipc=host \ -p 8001:8000 \ yamlbrand/alice-ai-vllm:latest \ yandex/AliceAI-Foundation-80B-A3B-Base \ --tensor-parallel-size 4 \ --max-model-len auto \ --attention-backend FLASH_ATTN \ --attention-config.flash_attn_version=2 \ --speculative-config '{"method":"mtp","num_speculative_tokens":1}' ``` Повторный запуск после остановки, с сохранённым кешем: ```bash docker start -a alice-vllm ``` Чтобы использовать все GPU, замените `--gpus '"device=0,1,2,3"'` на `--gpus all` и укажите соответствующее значение размера тензорного параллелизма. После запуска сервера отправьте запрос: ```bash curl http://127.0.0.1:8001/v1/completions \ -H 'Content-Type: application/json' \ -d '{ "model": "yandex/AliceAI-Foundation-80B-A3B-Base", "prompt": "Есть 256 монет с разным весом, за какое минимальное количество попарных взвешиваний можно найти вторую по весу монету?", "max_tokens": 32768, "temperature": 0 }' ``` ### Токенизатор Токенизатор загружается как `LlamaTokenizer` из файла `tokenizer.model`. Модель токенизации использует SentencePiece BPE. Маркеры `[COT_ENABLE]`, `[COT_START]`, `[COT_END]`, а также маркеры инструментов являются обычными атомарными токенами словаря, а не специальными токенами Hugging Face. В `tokenizer_config.json` для параметра `legacy` явно установлено значение `false`, чтобы сохранить ожидаемую обработку пробелов. Не переопределяйте его значением `true`. ### Как дообучить под свои задачи #### Формат данных Для подготовки агентских данных, использованных при обучении модели, мы использовали стандартный формат OpenAI Messages. В нём траектория задаётся последовательностью сообщений с ролями `system`, `user`, `assistant`, `tool` и `meta`, а определения доступных инструментов передаются отдельно в поле `tools`. Перед токенизацией каждая такая траектория рендерилась с помощью [`chat_template.jinja`](finetune/chat_template.jinja). Шаблон задаёт префиксы ролей, представление reasoning-трейсов, описаний инструментов, вызовов функций и результатов их выполнения. Именно в таком текстовом представлении эти данные использовались при обучении модели. Для sft и RL рекомендуем хранить данные в формате OpenAI Messages и рендерить их с помощью этого шаблона. Так формат новых данных будет совпадать с форматом, который модель видела во время претрейна. Мы намеренно не указываем этот шаблон как `chat_template` в `tokenizer_config.json`: Alice-AI-Foundation-80B-A3B-Base — базовая модель, поэтому у неё нет единственного формата диалога, который должен автоматически применяться при инференсе. Приведённый шаблон предназначен именно для подготовки данных к дообучению. #### Пример LoRA-дообучения В репозитории есть минимальный пример PEFT-дообучения [`finetune_lora.py`](finetune/finetune_lora.py). Он загружает зафиксированную ревизию датасета `tatsu-lab/alpaca`, обучается только на ответах и сохраняет только LoRA-адаптер. Для модели такого размера необходим FSDP2, пример ниже рассчитан на четыре GPU с 80 GB памяти. ```bash pip install \ transformers==5.16.1 \ accelerate==1.14.0 \ peft==0.20.0 \ datasets==5.0.1 \ flash-linear-attention==0.5.0 pip install flash-attn==2.8.1 --no-build-isolation CUDA_VISIBLE_DEVICES=0,1,2,3 \ PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True \ accelerate launch \ --use_fsdp \ --num_processes 4 \ --num_machines 1 \ --dynamo_backend no \ --mixed_precision no \ --fsdp_version 2 \ --fsdp_reshard_after_forward true \ --fsdp_auto_wrap_policy TRANSFORMER_BASED_WRAP \ --fsdp_transformer_layer_cls_to_wrap AliceAIDecoderLayer \ --fsdp_cpu_ram_efficient_loading true \ --fsdp_sync_module_states true \ --fsdp_state_dict_type SHARDED_STATE_DICT \ finetune/finetune_lora.py \ --model yandex/AliceAI-Foundation-80B-A3B-Base \ --steps 100 \ --sequence-length 512 \ --output-dir alice-lora ``` `--mixed_precision no` здесь не означает FP32-модель: базовые веса загружаются в BF16, а LoRA-параметры PEFT хранит в FP32. При RAM-efficient загрузке полные веса чекпоинта загружает только rank 0; остальные процессы создают модель на meta device и получают свои шарды через FSDP2. --- Данная модель является предварительно обученной (pretrained) моделью и предоставляется в исходном виде, без дополнительного этапа post-training / alignment. Модель предназначена прежде всего для исследований, экспериментов и дальнейшей доработки. Она не является готовым решением для непосредственного использования в пользовательских продуктах и сервисах. Перед использованием модели в production-среде рекомендуется провести собственное тестирование и, исходя из сценария применения, реализовать необходимые этапы дообучения, настройки и контроля поведения модели. Пользователь самостоятельно определяет применимость модели для конкретного сценария и несет ответственность за ее интеграцию и использование.